Google presenta StreamVibe, un asistente de video que decide cuándo intervenir
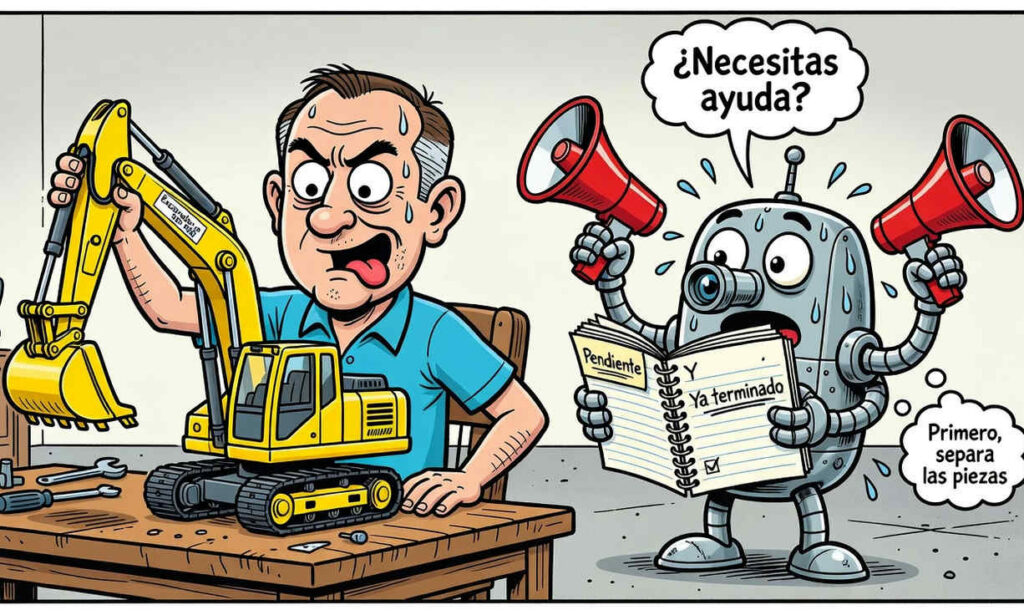
Google y un equipo académico presentan StreamVibe, un asistente de video que intenta reconocer cuándo una persona necesita ayuda aunque no lo pida de forma explícita. El proyecto aborda una limitación habitual de los asistentes de video: pueden reaccionar ante una señal explícita, pero les cuesta inferir intenciones no dichas, seguir los pasos ya completados y adaptarse cuando el usuario cambia de objetivo.
El benchmark de StreamVibe incluye cerca de 4.100 ejemplos de evaluación y 85.000 de entrenamiento; abarca más de 183 horas de videos cotidianos y de software. El equipo compiló StreamVibe-Bench, un benchmark con cerca de 4.100 ejemplos de evaluación y 85.000 de entrenamiento. Gemini 2.5 Flash propuso cuándo debía intervenir el asistente y qué debía decir en cada ejemplo.
Cuatro evaluadores humanos revisaron cada caso y solo lo aprobaron cuando los cuatro coincidieron. Los investigadores entrenaron StreamVibe-VL, un modelo que parece basarse en Qwen3.5-9B de Alibaba. El sistema decide cada segundo si guarda silencio o habla, y una segunda fase de entrenamiento con aprendizaje por refuerzo busca que se comporte con mayor cautela y no interrumpa a cada momento.
El diseño incorpora un sistema de memoria separado que registra qué solicitudes siguen pendientes y qué etapas de la tarea ya terminaron. Los investigadores reportan que StreamVibe-VL mejora en 10,7% el momento y la calidad de las respuestas frente a otros modelos. En las comparaciones descritas, StreamVibe-VL supera generalmente a su modelo base y a otros sistemas de código abierto.
Gemini 3.8 Flash, el modelo propietario de Google citado en el artículo, obtiene mejores puntuaciones en varias pruebas. El problema más persistente aparece cuando los sistemas procesan una grabación completa y tienen que apoyarse en lo que respondieron anteriormente. En pruebas donde solo deben decidir en momentos específicos, a menudo toman una decisión adecuada; en operación continua, los errores se acumulan.
En videos de más de cinco minutos, los modelos rara vez eligen el momento correcto para intervenir y encuentran especial dificultad para seguir una instrucción modificada durante un periodo prolongado. Un tutorial de GIMP incluido en el artículo muestra el reto de llevar un seguimiento preciso de los pasos.
En otra demostración, una guía para preparar tostadas enrolladas con mermelada, algunos modelos se limitan a describir lo que ven, por ejemplo, que alguien aplana el pan. StreamVibe-VL, en cambio, recomienda cortar primero la corteza, una sugerencia más orientada a la tarea que a narrar la escena.