TokenGate acelera el prefill de modelos de IA con mejoras de hasta 11,3x
Investigadores de Stanford y UC Berkeley presentaron TokenGate, una técnica para acelerar el prefill de modelos de IA, reduciendo el tiempo hasta el primer token en 11,3 veces frente al prefill completo en pruebas con modelos Qwen. El método reduce el uso de memoria entre 1,5x y 3,4x en las pruebas realizadas.
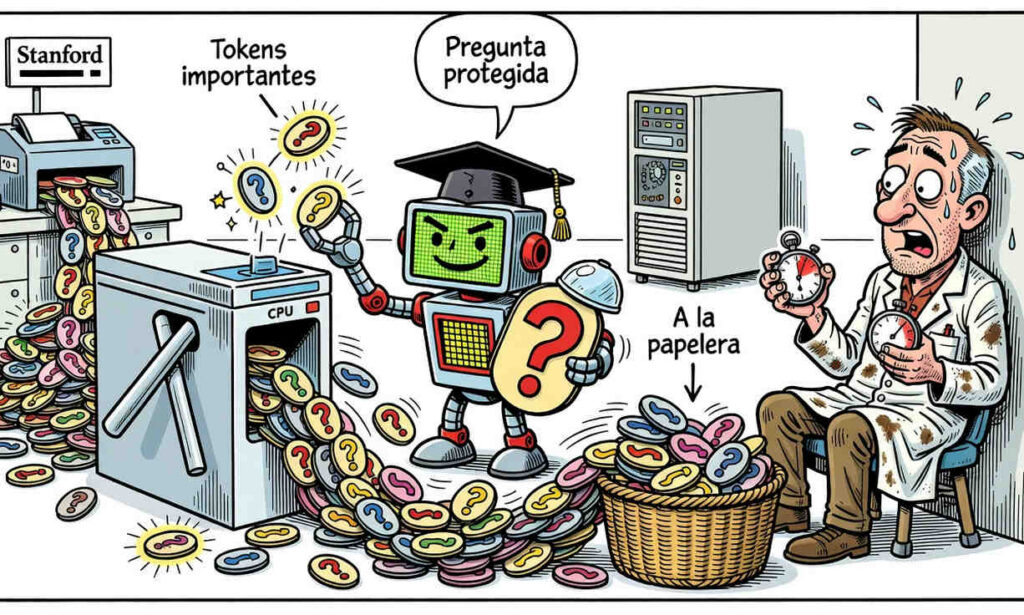
TokenGate incorpora una compuerta entrenable que selecciona qué tokens procesar en las capas superiores. Las pruebas se realizaron con modelos Qwen3-1.7B y Qwen3.5-2B, mostrando mejoras en eficiencia. El método no elimina el prefill, sino que optimiza el procesamiento de tokens en capas superiores.
El sistema se probó en tareas como RepoBench-P, 2WikiMultihopQA, MultiNews, BioDEX y needle-in-a-haystack. En la tarea needle-in-a-haystack con 16.000 tokens, TokenGate mostró una aceleración de 11,3x. El método se puede aplicar a modelos preentrenados sin requerir un cambio arquitectónico completo.
TokenGate utiliza una red MLP como compuerta y LoRA con rango 16 en los modelos evaluados. El entrenamiento de TokenGate fue 1,3x más lento que el de LoRA simple, pero convergió más rápido en algunas tareas. El código y checkpoints de TokenGate se publicaron bajo la licencia Apache-2.0.
El método permite ajustar el presupuesto de tokens de prefill para optimizar el ahorro de recursos. Según los investigadores, TokenGate ‘selecciona qué partes de un contexto largo merecen procesamiento completo’. El sistema consiguió mejoras de entre 1,4x y 11,3x en el tiempo hasta el primer token, según MarkTechPost.
Los investigadores destacaron que ‘TokenGate no elimina esa etapa ni sustituye al modelo completo: busca que las capas superiores procesen una selección de los tokens del documento’.